אודסיטי · Nanodegree · 12 קורסים · 49 שעות
מסלול Nanodegree בלמידת מכונה (ML) — אודסיטי
המסלול מורכב משנים-עשר קורסים ברצף: מבוא ללמידת מכונה · למידה מונחית · מבוא לרשתות עצביות עם TensorFlow · למידה לא-מונחית · ועוד…
מסלול-מבוא ללמידת מכונה ב-TensorFlow — אבל לא למתחילים מאפס: למי שכבר כותב פייתון ברמת ביניים ומכיר סטטיסטיקה תיאורית והסתברות. שלושה פרויקטים סטנדרטיים — לא תיק שמכסה את כל התחום, ולא ייחודיים למסלול. בקצב של אדם עובד: כחודש וחצי עד חודשיים.
סרטון קצר על אודסיטי · 2:41
49ש׳
משך רשמי
ביניים
רמת כניסה
12 · 3
קורסים · פרויקטים
4.6★
275 מדרגים
2חוד׳
עד סיום · שלנו
הרשמה ותמחור מתבצעים אצל אודסיטי · קישור שיווקי · אנחנו לא מוכרים את הקורס
בשורה אחת
חמש שאלות, חמש תשובות
אם אין לך זמן לקרוא את כל העמוד — אלה התשובות שמספיקות כדי להחליט.
למי זה
למי שכבר כותב פייתון ברמת ביניים, מכיר סטטיסטיקה תיאורית והסתברות בסיסית, ורוצה לעבור מעבודה עם נתונים לבניית מודלים.
מה יוצא ביד
שלושה תוצרים — מסווג למידה-מונחית של CharityML, מסווג תמונות ב-TensorFlow עם אפליקציית שורת-פקודה, וניתוח פלחי-לקוחות על מאגר ארוואטו.
כמה זמן באמת
49 שעות לקורסי-הליבה — כחודש וחצי עד חודשיים בקצב של 6 עד 8 שעות בשבוע. עם כל דרישות-הקדם והחומר הנוסף שבסילבוס (כ-140 שעות) זה כארבעה עד חמישה וחצי חודשים באותו קצב.
איפה זה ממקם אותך
בין ניתוח נתונים לבניית מודלים — כל יכולת כאן נגזרת מפרויקט בשם, ולפי אודסיטי, שלושת הפרויקטים נבדקים בידי אדם מול רובריקה.
מה חסר
הכיתה, הסילבוס והרובריקות באנגלית, אין בסילבוס פריסת מודלים לייצור וניטור שלהם, והמחיר נקבע ומתפרסם אצל אודסיטי בלבד.
המסגרת במספרים
49 שעות, ומה שיוצא מהן
אלה המספרים שאודסיטי עצמה מפרסמת בעמוד-המוצר. נמדדו ב-8.9.2026.
49
שעות רשמיות
בקצב של 6 עד 8 שעות בשבוע — כחודש וחצי עד חודשיים בקצב הזה
12
קורסים
74
שיעורים
3
פרויקטים
4.6
275 מדרגים
אוגוסט 2026
עודכן
2
עד סיום · שלנו
מסלול הלימוד
12 קורסים ברצף אחד
אורך העמודה מציג את יחס השעות בין הקורסים. פתח קורס כדי לראות כל שיעור בשמו.
קורס 1
מבוא ללמידת מכונה
1.8ש׳
קורס 2
למידה מונחית
16.5ש׳
קורס 3
מבוא לרשתות עצביות עם TensorFlow
17.2ש׳
קורס 4
למידה לא-מונחית
13.8ש׳
קורס 5
ברכות!
0.2ש׳
קורס 6
דרישת-קדם: פייתון לניתוח נתונים
12.2ש׳
קורס 7
דרישת-קדם: SQL לניתוח נתונים
15.5ש׳
קורס 8
דרישת-קדם: יסודות שורת-הפקודה
1.5ש׳
קורס 9
דרישת-קדם: Git ו-GitHub
14.8ש׳
קורס 10
חומר נוסף: פייתון להצגה חזותית של נתונים
13ש׳
קורס 11
חומר נוסף: סטטיסטיקה לניתוח נתונים
29.5ש׳
קורס 12
חומר נוסף: אלגברה לינארית
4ש׳
1מבוא ללמידת מכונה1.8 שעות
- ברוכים הבאים ללמידת מכונה — היכרות עם מבנה התוכנית ועם הפרויקטים שתעבוד עליהם בה.
- איך מקבלים עזרה — חמש דקות קריאה על הדרכים לקבל עזרה בתוכן ובהגשות.
- [רשות] הגדרת המחשב — התקנת פייתון 3 באמצעות אנקונדה והגדרת עורך טקסט.
2למידה מונחית16.5 שעות
- מבוא ללמידה מונחית — מבט-על על התחום כולו לפני הצלילה לאלגוריתמים.
- רגרסיה לינארית — איך עובד אחד האלגוריתמים הבסיסיים ביותר בלמידת מכונה.
- אלגוריתם הפרספטרון — אלגוריתם לסיווג נתונים שהוא אבן-הבניין של רשתות עצביות.
- עצי החלטה — מבנה לקבלת החלטות שבו כל החלטה מובילה לתוצאות או להחלטות נוספות.
- נאיב בייס — אלגוריתמים לבניית מסווגים, בשימוש נפוץ בנתוני טקסט ובבעיות סיווג.
- מכונות וקטורים תומכים — שיטת סיווג נפוצה שיעילותה נשענת על טריק הגרעין.
- שיטות אנסמבל — באגינג ובוסטינג לצירוף אלגוריתמים פשוטים למודלים חזקים יותר.
- מדדי הערכת מודל — המדדים המרכזיים להערכת מודלים, ובהם accuracy (נכונות), precision ו-recall.
- אימון וכוונון — סוגי השגיאות שקורות באימון והשיטות לטפל בהן ולייעל את המודל.
- פרויקטאיתור תורמים
3מבוא לרשתות עצביות עם TensorFlow17.2 שעות
- פתיחת הקורס — היכרות עם המרצים, עם התוכן, עם דרישות-הקדם ועם סביבות העבודה והמחברות.
- מבוא לרשתות עצביות — יסודות הלמידה העמוקה, ומימוש ירידת גרדיאנט והתפשטות לאחור בפייתון בתוך הכיתה.
- מימוש ירידת גרדיאנט — פונקציית שגיאה אחרת ומימוש בכפל מטריצות עם NumPy.
- אימון רשתות עצביות — כמה טכניקות לשיפור האימון של רשתות עצביות.
- למידה עמוקה עם TensorFlow — שימוש ב-TensorFlow לבניית מודלים של למידה עמוקה.
- פרויקטמסווג תמונות
4למידה לא-מונחית13.8 שעות
- אשכול — שיטת הלמידה הלא-מונחית הנפוצה, עם אלגוריתם K-means.
- אשכול היררכי ואשכול מבוסס-צפיפות — המשך שיטות האשכול, כולל DBSCAN.
- מודלי תערובת גאוסיאנית ותיקוף אשכולות — אשכול בשיטת תערובת גאוסיאנית ותהליך תיקוף התוצאות.
- הפחתת ממדים ו-PCA — צמצום מספר המאפיינים בנתונים בשיטת ניתוח רכיבים עיקריים.
- הטלה אקראית ו-ICA — שתי שיטות נוספות לחילוץ מאפיינים ולהפחתת ממדים.
- פרויקטזיהוי פלחי לקוחות
5ברכות!0.2 שעות
- ברכות! — ציון סיום התוכנית.
6דרישת-קדם: פייתון לניתוח נתונים12.2 שעות
- למה לתכנת בפייתון — סקירה של הקורס.
- טיפוסי נתונים ואופרטורים — אבני-הבניין של פייתון: טיפוסים, פונקציות מובנות, המרות וכללי סגנון.
- בקרת זרימה — תנאים, לולאות ובניית רשימות בשורה אחת (list comprehensions).
- פונקציות — פונקציות, תחום-הגדרה של משתנים, תיעוד, ביטויי למדא ומחוללים.
- סקריפטים — הקמת סביבת עבודה מקומית, כתיבת סקריפטים והרצתם.
- NumPy — יסודות NumPy ויצירת מערכים ועיבודם.
- Pandas — יסודות Series ו-DataFrame לטעינת נתונים ולעיבודם.
7דרישת-קדם: SQL לניתוח נתונים15.5 שעות
- SQL בסיסי — הפקודות המרכזיות לעבודה עם טבלה אחת ולסינון שלה בדרכים שונות.
- צירופי טבלאות — חיבור נתונים מכמה טבלאות יחד.
- פונקציות איגוד — סיכום נתונים בעזרת פונקציות SQL.
- תת-שאילתות וטבלאות זמניות — סוגי תת-השאילתות, התחביר שלהן והשימושים המתאימים.
- פונקציות חלון — השוואה בין שורות בלי צירופי טבלאות.
- ניקוי נתונים ב-SQL — ניקוי נתונים כחלק מתהליך הניתוח.
- צירופים מתקדמים וכוונון ביצועים — שאילתות שרצות מהר על מאגרים ענקיים ומקרי-קצה שעולים בראיונות.
8דרישת-קדם: יסודות שורת-הפקודה1.5 שעות
- סדנת שורת-פקודה — מבוא קצר לשימוש במעטפת (shell) של יוניקס במחשב שלך.
9דרישת-קדם: Git ו-GitHub14.8 שעות
- מהי בקרת גרסאות — היתרונות של בקרת גרסאות והתקנת Git.
- יצירת מאגר Git — איך יוצרים מאגר חדש.
- סקירת היסטוריית המאגר — קריאה של היסטוריית הקומיטים במאגר קיים.
- הוספת קומיטים למאגר — ביצוע commit, כתיבת הודעות תיאוריות ובדיקת השינויים לפני השמירה.
- תיוג, ענפים ומיזוג — עבודה מבודדת על הפרויקט בעזרת ענפים.
- ביטול שינויים — ביטול ותיקון של קומיטים שכבר נשמרו במאגר.
- עבודה עם מאגרים מרוחקים — יצירת מאגר מרוחק ב-GitHub ושליחת שינויים אליו.
- עבודה על מאגר של מפתח אחר — פיצול פרויקט של אחרים ותרומה לפרויקט ציבורי.
- סנכרון מול מאגר מרוחק — בקשות משיכה ושימוש בפקודת rebase לאיחוד קומיטים.
10חומר נוסף: פייתון להצגה חזותית של נתונים13 שעות
- הצגה חזותית בתהליך ניתוח הנתונים — למה זה חלק חשוב בתהליך ואיפה זה משתלב.
- עיצוב תצוגות — מרכיבי העיצוב, ובעיקר אלה שגורמים לתצוגה להיכשל.
- חקירת משתנה יחיד — תצוגות של משתנה בודד עם matplotlib ו-seaborn.
- חקירת שני משתנים — בחינת הקשר בין שני משתנים.
- חקירת ריבוי משתנים — קשרים בין שלושה משתנים ומעלה.
- תצוגות מסבירות — ליטוש התרשימים כדי להעביר את הממצאים לאחרים.
- מקרה-בוחן בהצגה חזותית — יישום על גורמים שמשפיעים על מחירי יהלומים.
11חומר נוסף: סטטיסטיקה לניתוח נתונים29.5 שעות
- סטטיסטיקה תיאורית — חלק א׳ — טיפוסי נתונים, מדדי מרכז ויסודות הסימון הסטטיסטי.
- סטטיסטיקה תיאורית — חלק ב׳ — מדדי פיזור, צורה וחריגים, ומבט ראשון על סטטיסטיקה היסקית.
- מקרה-בוחן: קבלה ללימודים — לשאול את השאלות הנכונות, דרך פרדוקס סימפסון.
- הסתברות — יסודות ההסתברות במטבעות ובקוביות.
- ההתפלגות הבינומית — אחת ההתפלגויות הנפוצות בהסתברות.
- הסתברות מותנית — כללי ההסתברות לאירועים תלויים.
- כלל בייס — אחד הכללים המוכרים בסטטיסטיקה.
- תרגול הסתברות בפייתון — יישום החומר מהשיעורים הקודמים בקוד.
- תורת ההתפלגות הנורמלית — המתמטיקה שמובילה מהטלת מטבע להתפלגות נורמלית.
- התפלגויות דגימה ומשפט הגבול המרכזי — הבסיס לרווחי סמך ולבדיקת השערות.
- רווחי סמך — בניית רווח סמך לכל פרמטר בעזרת התפלגויות דגימה ובוטסטראפ.
- בדיקת השערות — הכלים ליצירת מבחן השערות ולניתוח התוצאות.
- מקרה-בוחן: מבחני A/B — איך עובד מבחן A/B בחברת לימודים מקוונת.
- רגרסיה — התאמת מודלים לינאריים בפייתון ופירוש התוצאות.
- רגרסיה לינארית מרובה — יישום מודלים מרובי-משתנים בפייתון ובדיקת טיב ההתאמה.
- רגרסיה לוגיסטית — יישום מודלים לוגיסטיים בפייתון ופירוש התוצאות.
12חומר נוסף: אלגברה לינארית4 שעות
- מבוא — הצצה לעולם האלגברה הלינארית ולמה הוא כלי מתמטי כל כך חשוב.
- וקטורים — אבן-הבניין הבסיסית של אלגברה לינארית.
- צירוף לינארי — שינוי גודל של וקטורים וחיבורם, והדמיה של התהליך.
- העתקה לינארית ומטריצות — מהי העתקה לינארית ואיך היא קשורה ישירות למטריצות.
איפה זה ממקם אותך
מה תדע לעשות לבד
- לבנות מסווג מונחה ב-scikit-learn ולהעריך אותו מול מדד-ייחוס בדיוק וב-F1
- לאמן מסווג תמונות ב-TensorFlow ולעטוף אותו באפליקציית שורת-פקודה
- לפלח לקוחות באשכולות ובהפחתת ממדים על נתונים אמיתיים
מה יישאר לך ביד
3 פרויקטים שמוגשים לבדיקה
כל פרויקט משויך לשיעור מסומן בסילבוס, ובסופו מגישים אותו לבדיקה.
- 01
למידה מונחית
איתור תורמים
מחברת קוד ודוח — מודל סיווג מונחה ב-scikit-learn מול מדד-ייחוס, עם דיוק וציון F1
- 02
מבוא לרשתות עצביות עם TensorFlow
מסווג תמונות
קובץ מכווץ: מחברת בגרסת HTML (חלק א׳) וקבצי אפליקציית שורת-הפקודה (חלק ב׳)
- 03
למידה לא-מונחית
זיהוי פלחי לקוחות
מחברת קוד עם חיזויים על מאגר ארוואטו — אשכול והפחתת ממדים
החסם של האנגלית
יש בכיתה עוזר שמדבר עברית
בתוך הכיתה של אודסיטי יושב עוזר בשם מארווין. שואלים בעברית — הוא עונה בעברית, על החומר שמוצג באותו רגע.
כל שאלה על מה שכתוב בעמוד
למשל: "תסביר לי במילים פשוטות את המושג שמופיע כאן". התשובה מתייחסת לשיעור שפתוח מולך.
סיכום, ואז בוחן
אפשר לבקש סיכום של השיעור שקוראים עכשיו, ואז לבקש שיבחן אותך לפני שממשיכים.
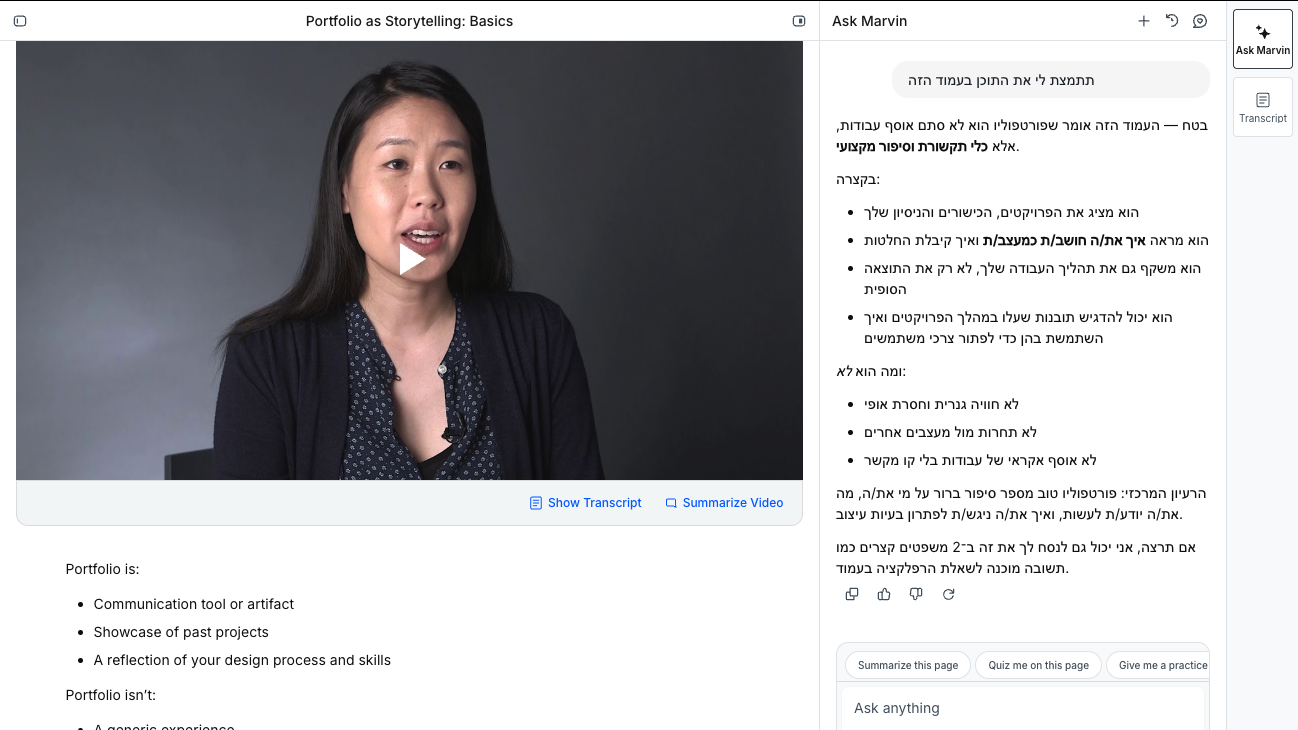
בדקנו את זה בפועל ב-7.9.2026: שלוש שאלות חופשיות, בקשת סיכום ובקשת בוחן — חמש מתוך חמש חזרו בעברית שוטפת ומדויקת לתוכן.
אחרי המסלול
לאיזו עבודה זה מספיק בישראל
מדען/ית נתונים
מה עושים בו ביום-יום
מפתחים מודלים סטטיסטיים ואלגוריתמי למידת-מכונה — סיווג, חיזוי, רגרסיה וזיהוי חריגות. מכינים את הדאטה: ניקוי, בניית מאפיינים, עבודה עם מידע מובנה ולא מובנה. מריצים ניסויים, מודדים ביצועים ומשפרים. מעבירים את המודל לייצור בשיתוף הפיתוח, כולל ממשק ושכבת שירות. מנטרים אותו אחרי שהוא באוויר. מתרגמים בעיה עסקית לניסוח אלגוריתמי ומציגים את התובנות.
מה המסלול נותן
שלושה פרויקטים שעוברים בדיקה אנושית: מסווג מונחה ב-scikit-learn שמוערך מול מדד-ייחוס בדיוק וב-F1 (איתור תורמים), מסווג תמונות ב-TensorFlow עם אפליקציית שורת-פקודה, ופילוח לקוחות באשכולות ובהפחתת ממדים על מאגר ארוואטו. זה חלק בניית-המודל של התפקיד. הכנת-דאטה מתקדמת, ניסויים מתמשכים והעברה לייצור — לא נמצאים כאן.
מה עוד תצטרך
זהו המקצוע הסגור ביותר לכניסה מבין 23 המקצועות שבדקנו. במודעות הישראליות הוא בנוי כשכבה מעל תפקידי-דאטה אחרים: שתי מודעות דורשות 3–5 שנים ב'תפקידי דאטה' (BI, אנליטיקה, הנדסת נתונים), ומתוכן רק שנה או שנתיים ב-Data Science עצמו. כלומר, הדרך הריאלית עוברת קודם בתפקיד אנליסט או מהנדס-נתונים. פער שני: התואר — הוא מופיע בכל מודעה שבדקנו, לפעמים תואר שני. פער שלישי: החצי השני של התפקיד הוא הוצאת המודל לייצור וניטורו — ניסיון תפעולי שאין בפרויקט-לימוד.
מהנדס/ת למידת-מכונה
מה עושים בו ביום-יום
מפתחים ומאמנים מודלים — סיווג, רגרסיה, חיזוי, זיהוי חריגות, רשתות עמוקות. מכינים דאטה ובונים מאפיינים. מודדים ביצועי-מודל ומריצים ניסויים. מעבירים מודלים לייצור ובונים סביבם ממשקים. מתחזקים את מחזור-החיים: גרסאות-מודל, ניטור, זיהוי סחיפה. בחלק מהמודעות — אופטימיזציית ביצועים של מודלי-שפה ולא אימון.
מה המסלול נותן
את המודלים עצמם: סיווג מונחה, רשת עצבית ב-TensorFlow ואשכולות — שלושה פרויקטים שנבדקים מול רובריקה. את חלק ה-MLOps של התפקיד — אריזת קוד, צינור-אימון, פריסה ב-API וניטור — המסלול הזה לא נותן.
מה עוד תצטרך
התוכן קרוב, והפער הוא בשלושה מקומות. (1) התואר: בחלק מהמודעות הוא חובה, ובמחקר הוא תואר שני או שלישי. (2) הוותק: ברוב המודעות שבדקנו (14 מתוך 25) נדרשו 3–4 שנות ניסיון, ולא מצאנו אף משרת-ML ישירה בלי ניסיון. (3) אל תסמוך על כותרת המשרה: מודעה בשם 'ML Engineer' עשויה להיות תפקיד תשתיות-דאטה בלי ML ברשימת-החובה, ומודעה בשם 'Senior ML Engineer' עשויה להיות הנדסת-inference (הרצת מודלים קיימים). הסימן האמין היחיד שמצאנו הוא רשימת-הספריות: PyTorch/TensorFlow מול LangChain או מסד-וקטורי.
✓זה בשבילך אם…
אתה כבר כותב פייתון ברמת ביניים ורוצה שלושה תוצרים סגורים שנבדקו בידי אדם; אתה רוצה גם את הצד המונחה, גם רשת עמוקה ב-TensorFlow וגם למידה לא-מונחית — באותו רצף; ונוח לך ללמוד באנגלית, ואתה מסוגל לעמוד בקצב של 6 עד 8 שעות בשבוע.
✕דלג עליו אם…
אין לך בסיס בפייתון, בסטטיסטיקה ובהסתברות ואינך מתכוון לעבור את קורסי דרישות-הקדם שבתוך המסלול; מה שאתה מחפש הוא הפעלת מודלים בייצור, ניטור וניהול מחזור-חיים — זה לא מה שכתוב בסילבוס; או שאתה צריך ליווי בעברית מאדם; העוזר בכיתה עונה בעברית, אבל הבדיקה והחומר לא.
לפני שמחליטים
מה זה לא נותן
- הפער בין משך הזמן הרשמי לסילבוס: 49 השעות מכסות את קורסי-הליבה; סכום השעות של כל שנים-עשר הקורסים בסילבוס, כולל דרישות-הקדם והחומר הנוסף, הוא כ-140 שעות.
- שלושה פרויקטים בלבד על תחום רחב: העמוד מונה 33 מיומנויות — מרגרסיה לינארית ועד DBSCAN — אבל מה שמוגש ונבדק הוא שלושה תוצרים.
- הפרויקטים אינם ייחודיים למסלול: לפי מה שקראנו בכיתה, פרויקט איתור התורמים ופרויקט פלחי הלקוחות זהים לאלה שבמסלול Intro to Machine Learning with PyTorch של אודסיטי; ההבדל המרכזי הוא TensorFlow במקום PyTorch. אם כבר עשית אותו — אין כאן חדש מלבד הספרייה.
- החומר והבדיקה באנגלית: השיעורים, ההוראות והבדיקה באנגלית בלבד — רק העוזר בכיתה עונה בעברית.
שאלות ותשובות
צריך לדעת פייתון לפני שנרשמים?
כן, ברמת ביניים. אודסיטי מגדירה את רמת הכניסה כביניים ומפרטת תשע דרישות-קדם, ובהן פייתון לניתוח נתונים, סטטיסטיקה תיאורית, הסתברות בסיסית וחשבון בסיסי. בתוך המסלול עצמו יושבים קורסי דרישות-קדם בפייתון, SQL, שורת-פקודה ו-Git, ולצידם חומר נוסף בסטטיסטיקה ובאלגברה לינארית. הם מאפשרים להשלים פערים, אבל רמת-הכניסה נשארת ביניים.
הכול באנגלית? אפשר להסתדר?
השיעורים, הוראות הפרויקטים והרובריקות באנגלית, וגם ההגשה נכתבת באנגלית. בתוך הכיתה יושב מארווין, עוזר AI שאפשר לשאול אותו בעברית, לבקש ממנו סיכום של העמוד שאתה קורא ולבקש שיבחן אותך — בדקנו את זה בפועל.
מה בדיוק מגישים בסוף?
שלושה תוצרים: מחברת ודוח של מודל סיווג מונחה בפרויקט איתור תורמים, קובץ מכווץ עם מחברת בגרסת HTML וקבצי אפליקציית שורת-פקודה בפרויקט מסווג התמונות, ומחברת עם חיזויים בפרויקט זיהוי פלחי הלקוחות.
הפרויקטים נבדקים בידי אדם?
אודסיטי מצהירה שההגשות נבדקות בידי אדם מול רובריקה, והרובריקה מופיעה כשלב נפרד בהוראות הפרויקט לפני ההגשה. את תוכן הרובריקה עצמה לא הצלחנו לתפוס בבדיקה שלנו בכיתה ב-8.9.2026.
כמה זמן זה באמת ייקח לי?
אודסיטי מפרסמת 49 שעות. בקצב של 6 עד 8 שעות בשבוע — קצב שאדם עובד מצליח לעמוד בו — זה כחודש וחצי עד חודשיים. סכום השעות של כל שנים-עשר הקורסים בסילבוס, כולל דרישות-הקדם והחומר הנוסף, הוא כ-140 שעות — כארבעה עד חמישה וחצי חודשים באותו קצב.
למה אין כאן מחיר?
המחיר נקבע ומתפרסם אצל אודסיטי, לפי מבנה-הרכישה שהיא מציעה ולפי מבצעים ומטבע. כל מספר שנכתוב יתיישן מהר, ולכן אנחנו שולחים אותך לעמוד המסלול — שם גם מופיעים תנאי הביטול.
49 שעות, שלושה פרויקטים, תיק אחד
המחיר, תנאי הביטול ומועד הפתיחה — בעמוד המסלול של אודסיטי. ההחלטה שלך.
הרשמה ותמחור מתבצעים אצל אודסיטי · קישור שיווקי · אנחנו לא מוכרים את הקורס
מקורות
- עמוד-המוצר הרשמי של המסלול Introduction to Machine Learning with TensorFlow באתר אודסיטי — משך, רמה, דירוג, מיומנויות, דרישות-קדם וסילבוס. נמדד ב-8.9.2026.
- הוראות הפרויקטים בתוך הכיתה של אודסיטי — שלבי הפרויקט, תוצרי ההגשה, הדרישות המספריות והבדיקה מול רובריקה. נקרא ב-8.9.2026.
MSL הוא קטלוג קורסים — לא ספק הקורס. המסלול מתפרסם ומנוהל על ידי אודסיטי. תוכן הקורס, המחיר, התעודה ותנאי השימוש הם באחריות אודסיטי בלבד. הקישורים לאודסיטי הם קישורים שיווקיים.